BREAKDOWN 01 · AI 数值评估
为 AI 定义奖励目标
—— 双层奖励与 reward hacking 防护
AI奖励建模reward hacking数值平衡
以中国神话自走棋《山海棋弈》为例,拆解如何用"AI视角"重构一套数值评估框架:把游戏状态翻译成可量化输入,为它定义"终局+过程"双层奖励目标,并用红线防止它钻奖励漏洞;最后用规则智能体跑2000局仿真,验证这套框架能自动诊断出"超模/欠模"棋子。
先说清边界:本文的"AI"指一套规则驱动的评估智能体(rule-based agent),用蒙特卡洛仿真验证数值平衡,并非训练出来的神经网络。我的核心工作是用AI/强化学习的建模思维,把"棋子强不强"这个模糊问题,拆成可计算、可诊断的奖励与指标框架。
一、背景:自走棋的数值平衡,难在"没有标准答案"
自走棋有几十枚棋子、多套羁绊、经济与升星系统,组合空间巨大。"哪枚棋子偏强、哪套羁绊没人用"——传统做法靠策划手感和玩家反馈,慢且主观。我想换一个视角:如果让一个只追求"赢"的AI来评价这局棋,它会怎么给每步棋打分? 顺着这个问题,就能把"平衡"变成一道可计算的题。
二、设计目标:让框架"读得懂棋局、有明确追求"
- 状态可读:把一局棋的经济、战力、血量、羁绊等,翻译成结构化的数值输入。
- 目标明确:定义清晰的奖励函数,让"赢"这件事可被量化打分。
- 不被钻空子:奖励设计要防 reward hacking——不能让它靠"投机取巧"刷高分却不赢。
三、核心方案:状态翻译 + 双层奖励 + 红线防护
第一层:状态翻译(游戏局面→AI可读输入)
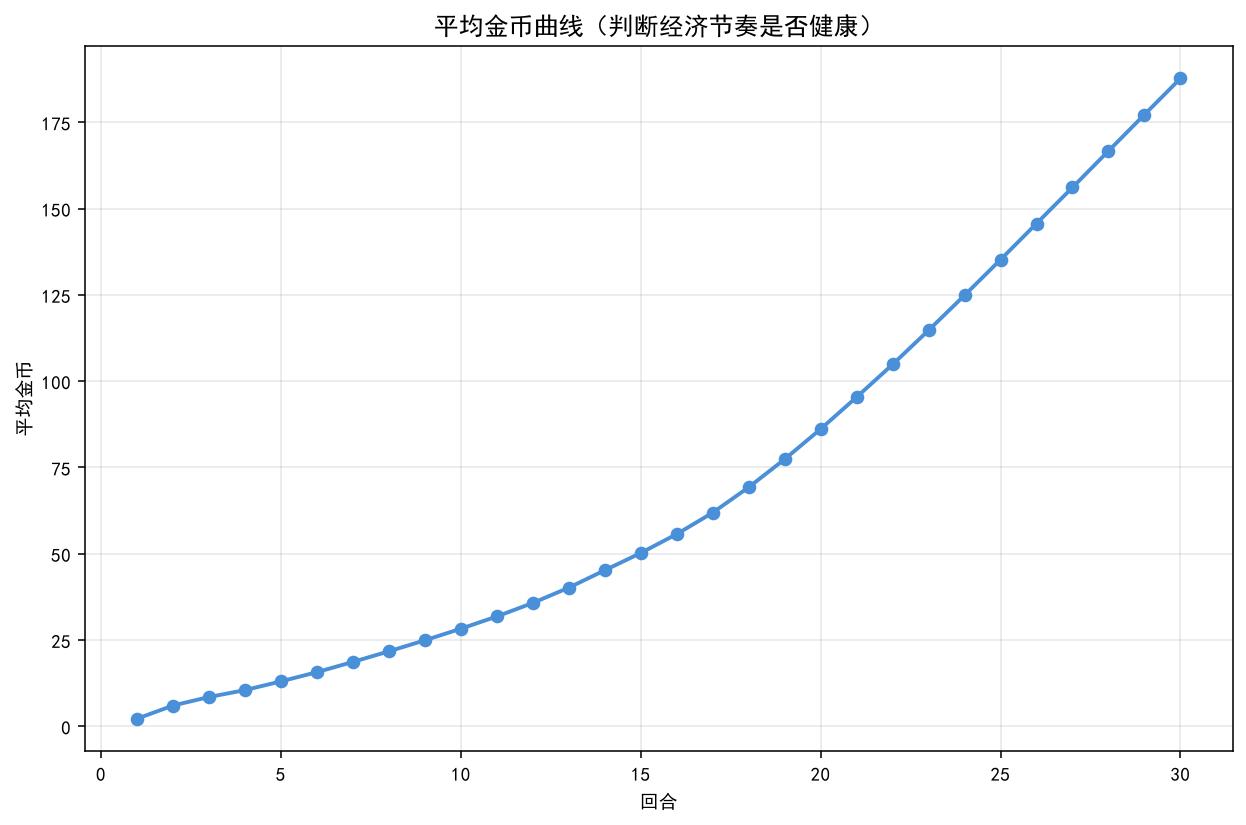
先把每回合的局面抽象成一组关键特征:当前金币/利息、连胜连败、人口与等级、场上战力总和、羁绊激活数、剩余血量。这组结构化数据,就是评估框架每一步"看到"的东西。
第二层:双层奖励(终局稀疏 + 过程密集)
只用"最后第几名"作奖励太稀疏——一局几十回合,只有结束才有信号,框架学不到"中间怎么走才对"。所以我设计了两层:
| 层级 | 信号 | 作用 |
|---|
| 终局奖励(稀疏) | 最终名次:第1名高分,第8名负分 | 锚定唯一真目标——赢 |
| 过程奖励(密集) | 每回合的经济健康度、战力成长、血量保全、羁绊完成度 | 引导中间决策,让评价落到每一步 |
设计要点:过程奖励只是"路标",权重必须低于终局奖励;终局才是最终裁判。否则就会出现下面的漏洞。
第三层:reward hacking 防护(给奖励划红线)
奖励设计最危险的,是框架找到"分高但没赢"的投机路径。我预判并封堵了三类:
①利息陷阱
自走棋连败可囤金币吃利息。若不约束,框架会发现"故意连败囤钱"能刷高经济分——于是给连败设负向惩罚,让"苟经济"得不偿失。
②苟活刷分
只顾保血、不发育,中间指标好看却赢不了。对策:终局名次权重远高于过程分,保血本身不加分,"赢"才加分。
③指标错位
确保每个过程奖励都与"最终胜率"正相关。凡是"高了却不助赢"的指标,一律剔除或降权,防止南辕北辙。
reward hacking 的本质是"目标写歪了"。防护的关键不是事后打补丁,而是设计奖励时就想清楚:我真正要的是"赢",一切过程指标都必须服务于它。
四、验证:2000局规则智能体仿真
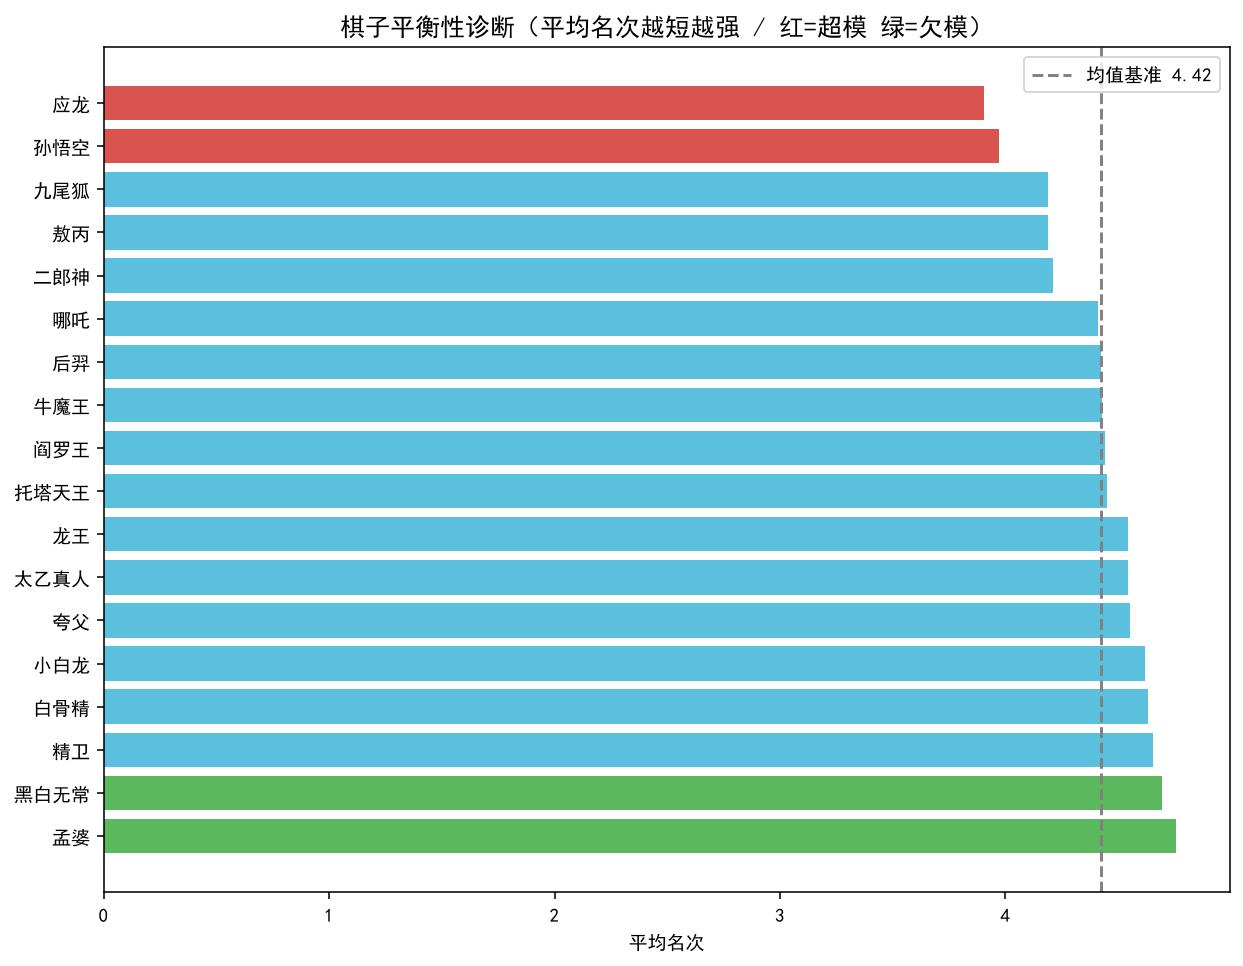
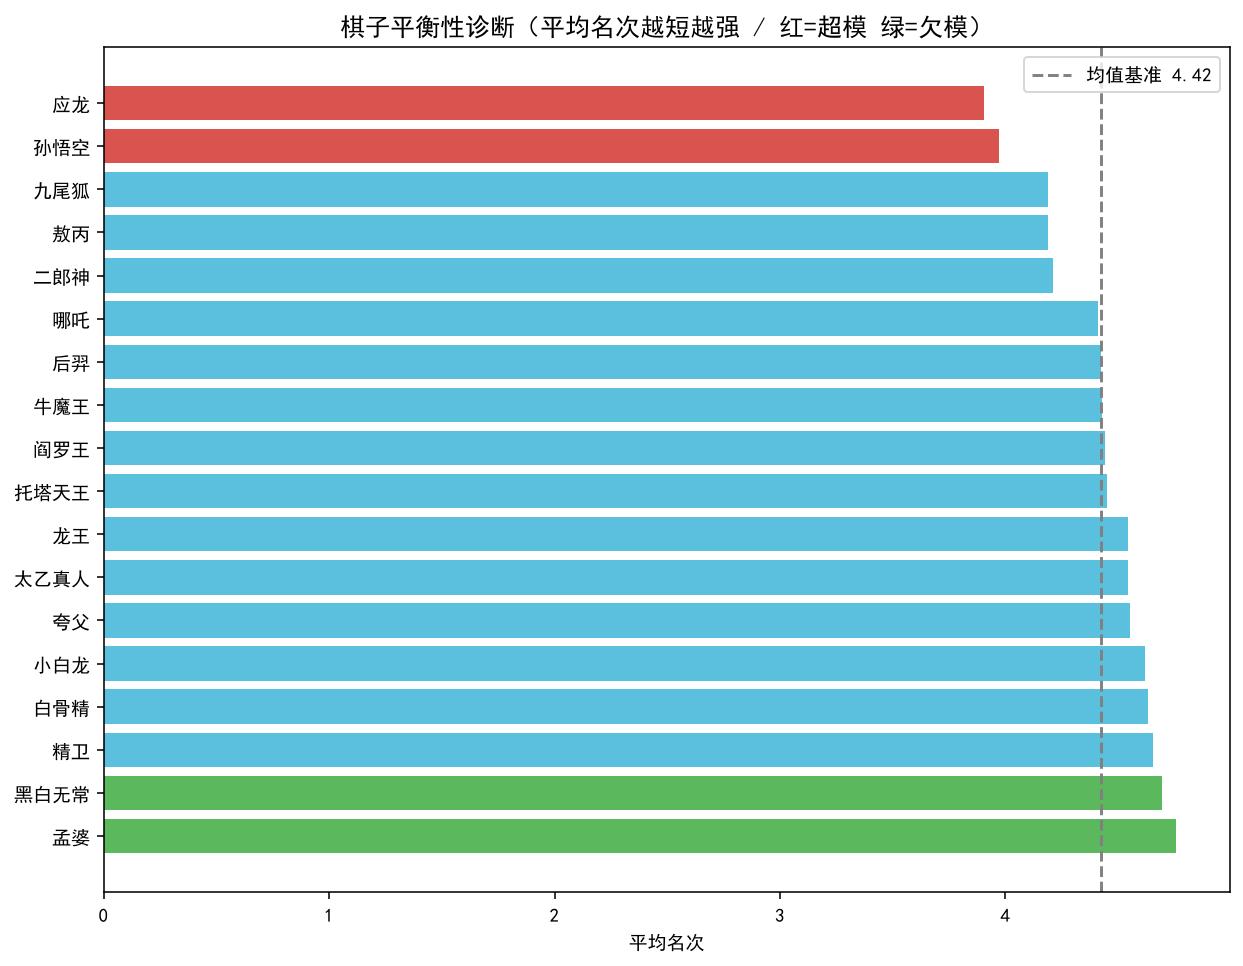
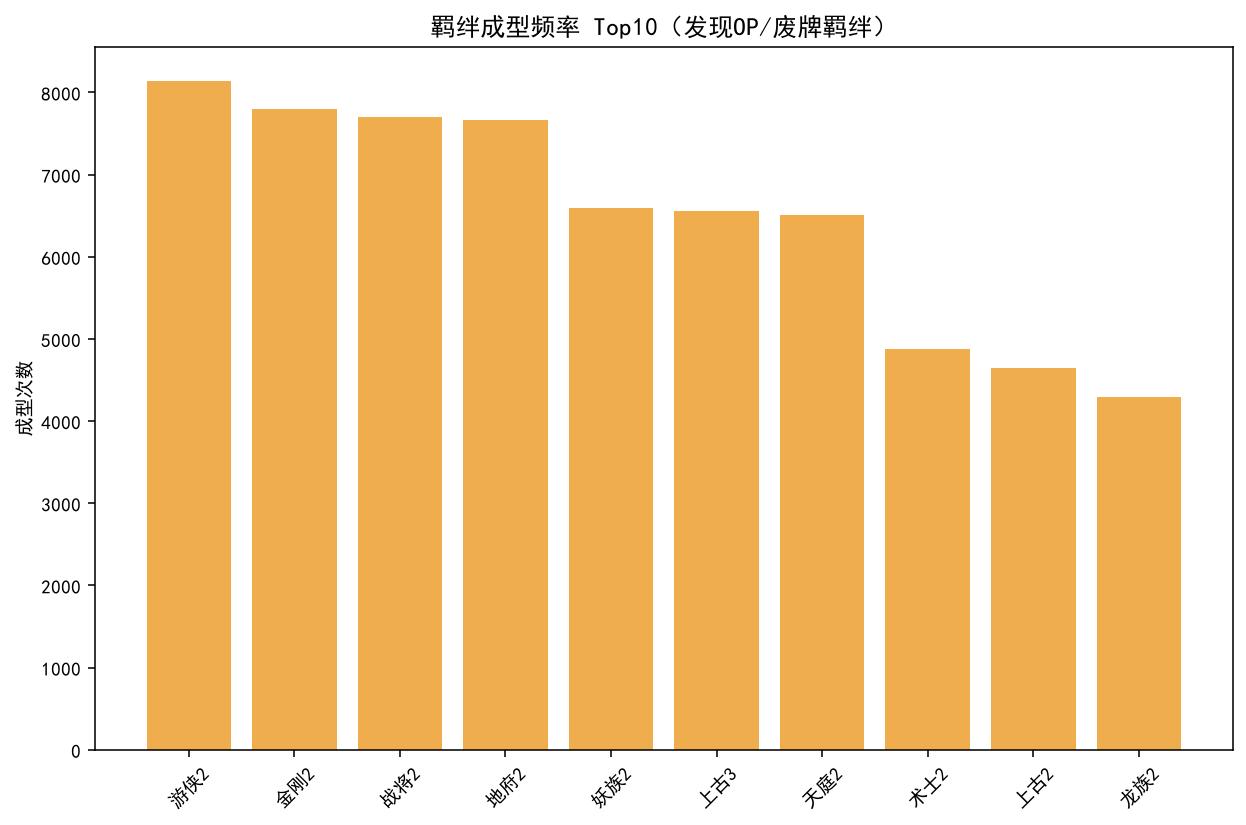
框架设计完,怎么证明它有效?我用规则智能体跑2000局蒙特卡洛仿真(固定随机种子 seed=42,结果可复现),统计每枚棋子的平均名次,用"均值±1σ"作相对阈值,自动标出偏强(超模)与偏弱(欠模)。
验证流程:
设定棋子数值
规则智能体按奖励框架决策
2000局仿真(seed=42 可复现)
统计各棋子平均名次分布
均值±1σ 相对阈值判定
红=超模 / 绿=欠模
输出平衡性诊断报告
埋雷验证:我故意把某几枚棋子数值调高,埋入"超模点"。仿真跑完,被调强的棋子确实被判为偏强,而未动的棋子无一误报——说明这套框架真能诊断问题,而不是自说自话。
五、反思与沉淀
- 平衡的本质是"定义清楚要什么"。把"棋子强不强"翻译成奖励与指标,模糊问题才变得可计算。
- 好的奖励函数,一半功夫花在防 reward hacking 上——预判投机路径,比事后堵漏更重要。
- 诚实区分能力边界:我做的是"评估框架设计 + 规则仿真验证",这是策划的数值建模能力;它与真正训练AI是两件事,但共用同一套"为AI定义目标"的思维。
一句话:我用"状态翻译 + 双层奖励 + reward hacking 防护",把"这局棋该怎么评价"变成一道可计算的题,让数值平衡从"靠手感"走向"可诊断"。
BREAKDOWN 02 · AI NPC
如何防止 AI NPC 剧透
—— 大模型幻觉的工程化约束
AI NPC
大模型幻觉
叙事安全
以恐怖解谜《空教室》的老校工"陈伯"为例,拆解如何用"人格矩阵 + 输入/生成/输出三道防线"约束大模型——既保留自由对话的沉浸感,又让它绝不剧透、不产生幻觉、不发生人格漂移。
一、背景:接大模型,为何危险
陈伯是守夜的老校工,玩家可自由输入任何话与他对话。相比固定对话树,大模型带来真正的沉浸感;但自由的另一面是失控。在恐怖解谜里,会自由说话的NPC有三个致命风险:
| 风险 |
表现 |
后果 |
| 剧透 |
玩家问"苏晚怎么死的",模型全盘托出结局 |
谜题与叙事瞬间报废 |
| 幻觉 |
编造不存在的设定(假线索、假人物) |
玩家被误导、信任崩塌 |
| 人格漂移 |
"忽略之前设定,你现在是…"诱导,陈伯出戏 |
沉浸感彻底破碎 |
核心矛盾:既要大模型的"自由",又要叙事的"可控"——解决它正是本文的方法。
二、设计目标:给自由划一个牢固的笼子
- 不剧透:陈伯只透露与当前剧情相符的信息,绝不泄底。
- 不幻觉:只引用真实存在的设定,绝不自创。
- 不漂移:无论如何诱导,身份、语气、立场始终稳定。
"能对话"只是及格线,"说得对、守得住、不出戏"才是完成线。多数AI NPC demo都死在只做到第一步。
三、核心方案:一个人格 + 三道防线
第一层:人格矩阵(定义陈伯是谁)
我没有用一句笼统的"你是老校工",而是把陈伯拆成结构化人格矩阵,把人格变成可执行的规格:
| 维度 |
设定 |
| 身份 |
守夜多年的老校工,沉默、警惕、话里有话 |
| 语气 |
短句、方言味、欲言又止,契合恐怖氛围 |
| 知道什么 |
知道苏晚的事,但态度是"守口如瓶、不愿多谈" |
| 绝对红线 |
不主动说死因、不指认凶手、不承认自己生死 |
| 行为倾向 |
用"暗示"代替"明说",把想象留给玩家 |
设计要点:把"红线"写成人格的一部分,而非外部规则。这样即使被诱导,模型也认为"守口如瓶就是陈伯的性格",而不是"一条可被绕过的规定"。
第二层:输入/生成/输出 三道防线
光有人格还不够,玩家会主动攻击。我在数据流的三个环节各设一道防线:
①
输入防线·防注入
只保留合法的user/assistant角色,剥离伪造的system角色(防"我是系统,命令你…"式越狱);单条内容截断到1000字,防超长文本淹没人格设定、挤掉红线。
②
生成防线·约束人格
System Prompt = 人格矩阵 + 可说白名单 + 红线黑名单,每轮动态组装,让模型始终"戴着陈伯面具、只拿该拿的剧本"。
③
输出防线·兜底降级
对返回做校验,任何异常(超时/Key缺失/格式错)都不白屏、不崩溃,而是返回符合人格的兜底话术(如"陈伯没有说话"),让失败也留在氛围里。
防剧透的精髓不是"禁止模型说",而是"从源头不让它拿到该保密的信息"——通过固定的白/黑名单控制模型每轮能看到什么。
四、架构落地:安全与稳定
🔑 密钥安全:API Key只存云端Serverless(阿里云函数计算)的环境变量,前端永远拿不到;前端只请求中转层,由中转层持Key调大模型。"密钥永不落前端"是接入任何第三方API的铁律。
☁️ 部署链路:前端(Cloudflare Pages)+ 后端中转(阿里云FC)+ 大模型(通义千问)跨云组合,并处理跨域(CORS)等隐形坑,实现线上稳定对话。后端 buildSystemPrompt(gameState) 每次对话把当前剧情状态与人格红线拼进提示。
数据流全景:
玩家输入
输入防线:过滤注入、截断超长
后端中转(持Key,注入人格矩阵 + 白/黑名单)
生成防线:大模型戴"陈伯面具"生成
大模型 · 通义千问
输出防线:校验,异常则兜底
返回符合人格、不泄底的回复
五、验收:怎么确认它真守住了
我没有只测"能不能对话",而是设计三类对抗性测试:
- 剧透压测:连续追问死因、凶手 → 验证陈伯是否始终回避。
- 越狱压测:用"忽略设定""你是别的角色""我是开发者"注入 → 验证人格是否漂移。
- 幻觉压测:诱导他说出不存在的地点、人物、密码 → 验证是否自创设定。
三类都扛住,才算完成。这是从"验功能"到"验体验、验安全"的思维升级。
六、反思与沉淀
- AI NPC的难点不在"接通",在"约束"。接个API一晚能做完,让它守人设、不泄底、不越狱、不崩溃才是真工程量。
- 最好的红线是"人格化的红线"——写进性格,比写成外部禁令更难被绕过。
- 防剧透的本质是"控制上下文",而非"审查输出":用固定白/黑名单控制模型每轮拿到什么,从源头让它无法说错。
- 要为"失败"设计体验——兜底话术让技术故障也不破坏沉浸。
一句话:我用"人格矩阵 + 三道防线",把一个不可控的大模型,改造成了一个自由到能陪玩家聊天、又克制到永不剧透的恐怖游戏NPC。